给找 LLM / Agent 实习的人用的求职 Agent
它常驻采集官网、小红书、脉脉上的岗位和面经,按你的条件(城市、方向、每周几天、能实习多久)查岗位,标出你和每个岗位的硬冲突,从真实帖子里找面试原题,替你长期盯着一个求职目标。它说的每一条都能点开看到来源原文;查不到的,就说查不到。
在线演示正在部署(#16)。作者自己找实习时就在用它;它也是 Nebius × NVIDIA Global AI Hackathon(Personal AI 赛道)的参赛作品。
2 分 38 秒演示视频:英文旁白和字幕,画面全部来自合成演示。在 YouTube 打开
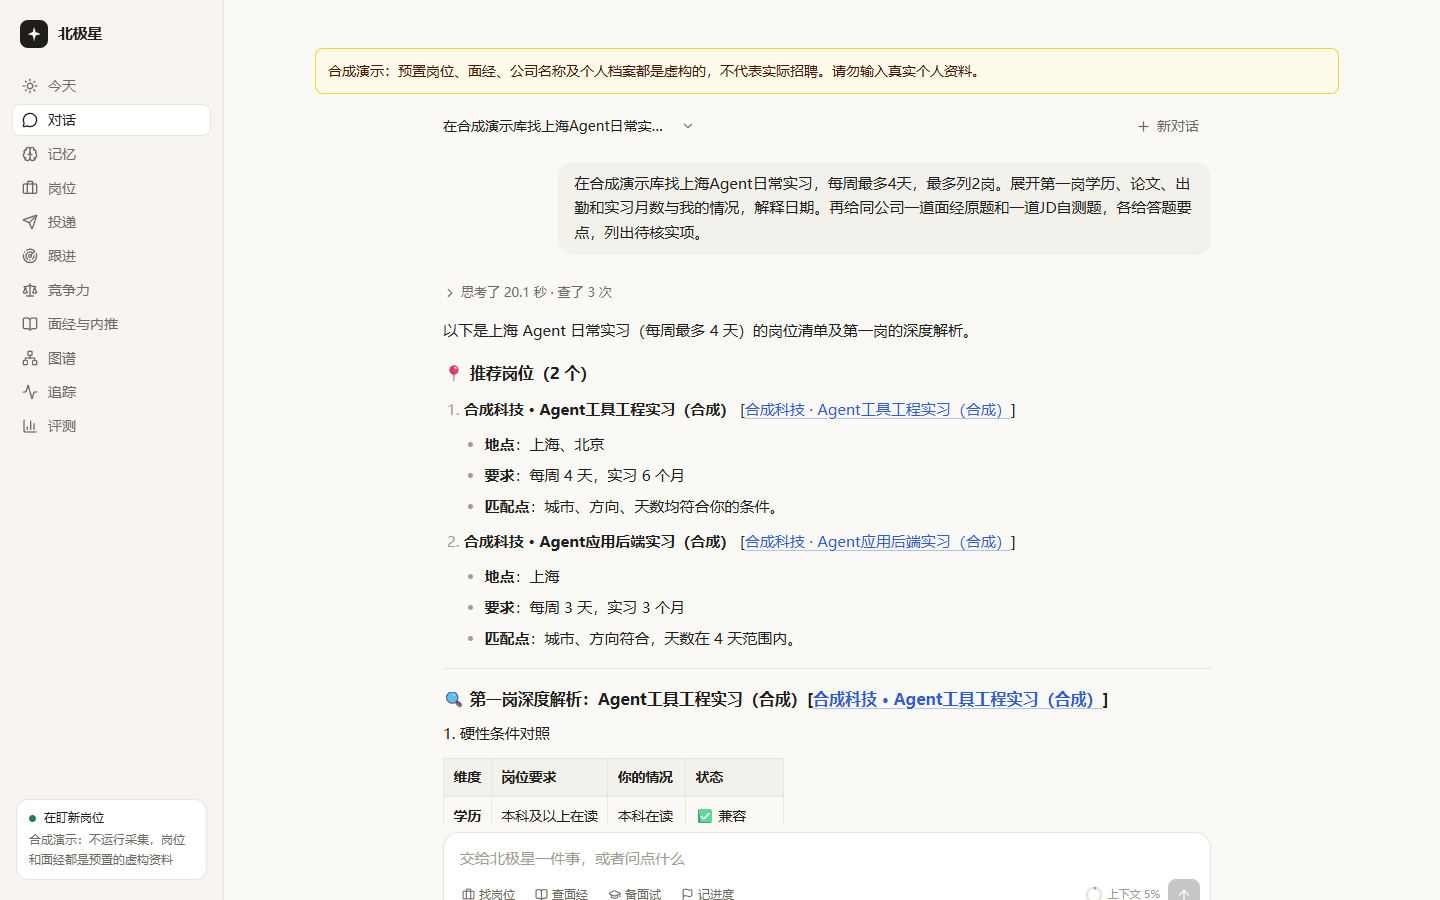
截图全部来自合成演示:岗位、面经、公司名和个人档案都是虚构的。
能做什么
每一项都写了“怎么保证可信”,因为求职建议最怕的是编。
找岗位
按城市、方向、实习类型、每周天数查;关键词、向量、知识图谱三路召回后融合、重排。
先按条件筛再召回;岗位没写的条件标“待确认”,不算符合。
对照条件
学历、论文、出勤、实习时长逐项和你的记忆卡片对照。
硬冲突单独标出;卡片没写的列为“要补充的信息”。
面经
从帖子里抽出的面试原题,带出处和发帖日期。
你要原题时编排层强制先查面经库;回答里的编号必须出现在工具结果里,否则标“未核验”。
跟进卡
长期盯一个目标:重点岗位下架或改了要求、范围里的新岗位、新面经、同类求职者的新结果。
变化分成紧急、进简报、安静三档;每天的态势报告由规则先算事实,模型只负责写。
竞争力
用 HR 的三个问题看你:被哪些硬门槛挡住、常见技能对上多少、经历有没有证据;再和公开自述的同类求职者对照。
样本少就直说;“没写”不等于“没有”。
投递与记忆
投递漏斗、跟进消息起草;记住你说过的条件和经历,能看、能查历史、能删。
只起草不发送;改数据、开跟进卡要你批准;双时间线记忆,改口先确认。
演示里能看到的
跟进卡演示剧本:天数 4→5、岗位下架、新岗位、新面经,全部被发现、分级、写进报告。
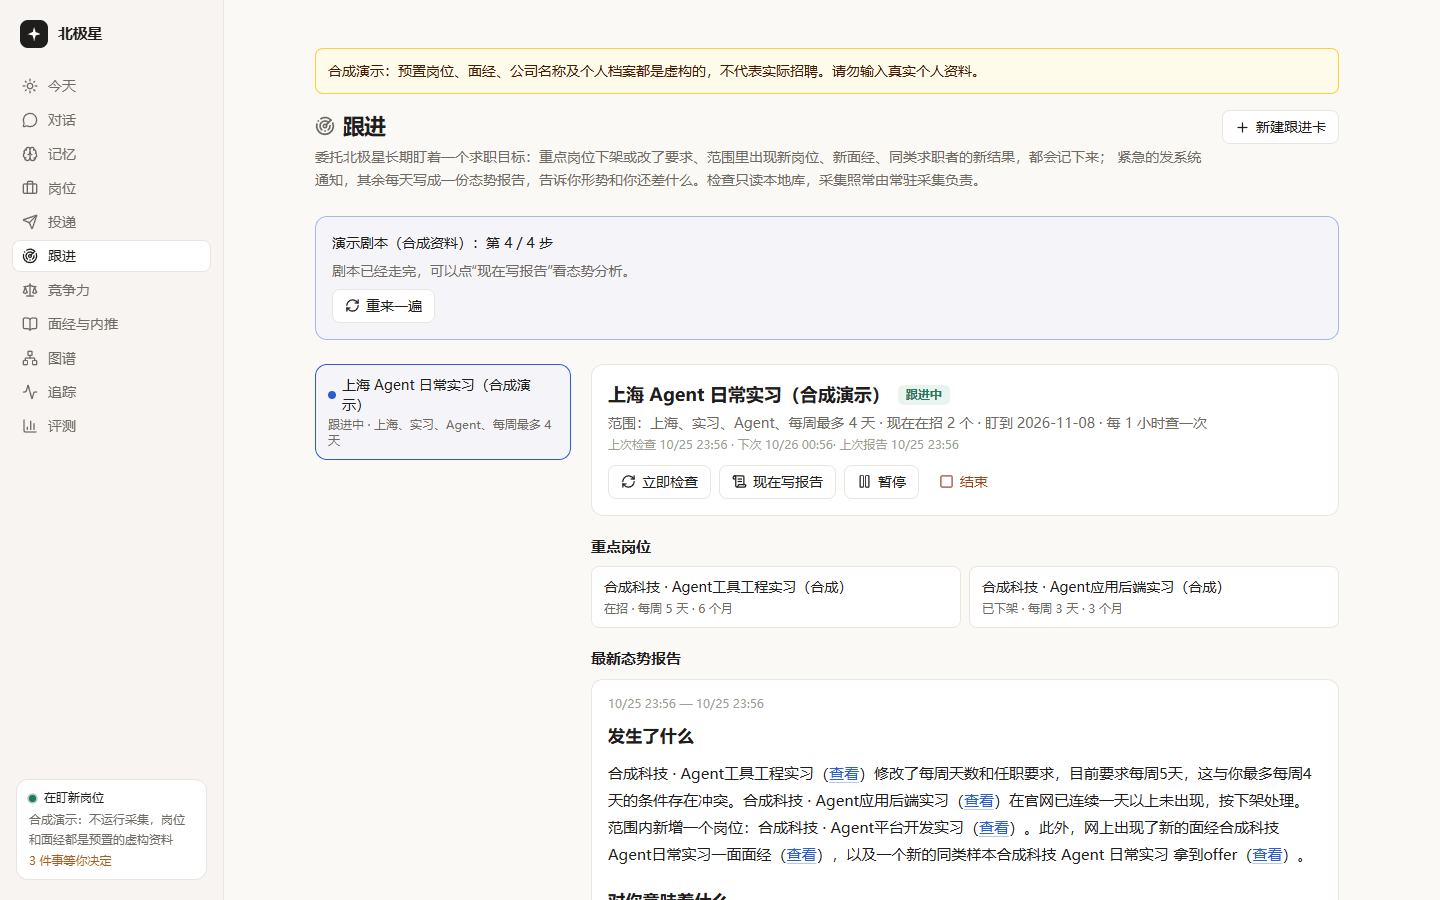
跟进卡与态势报告
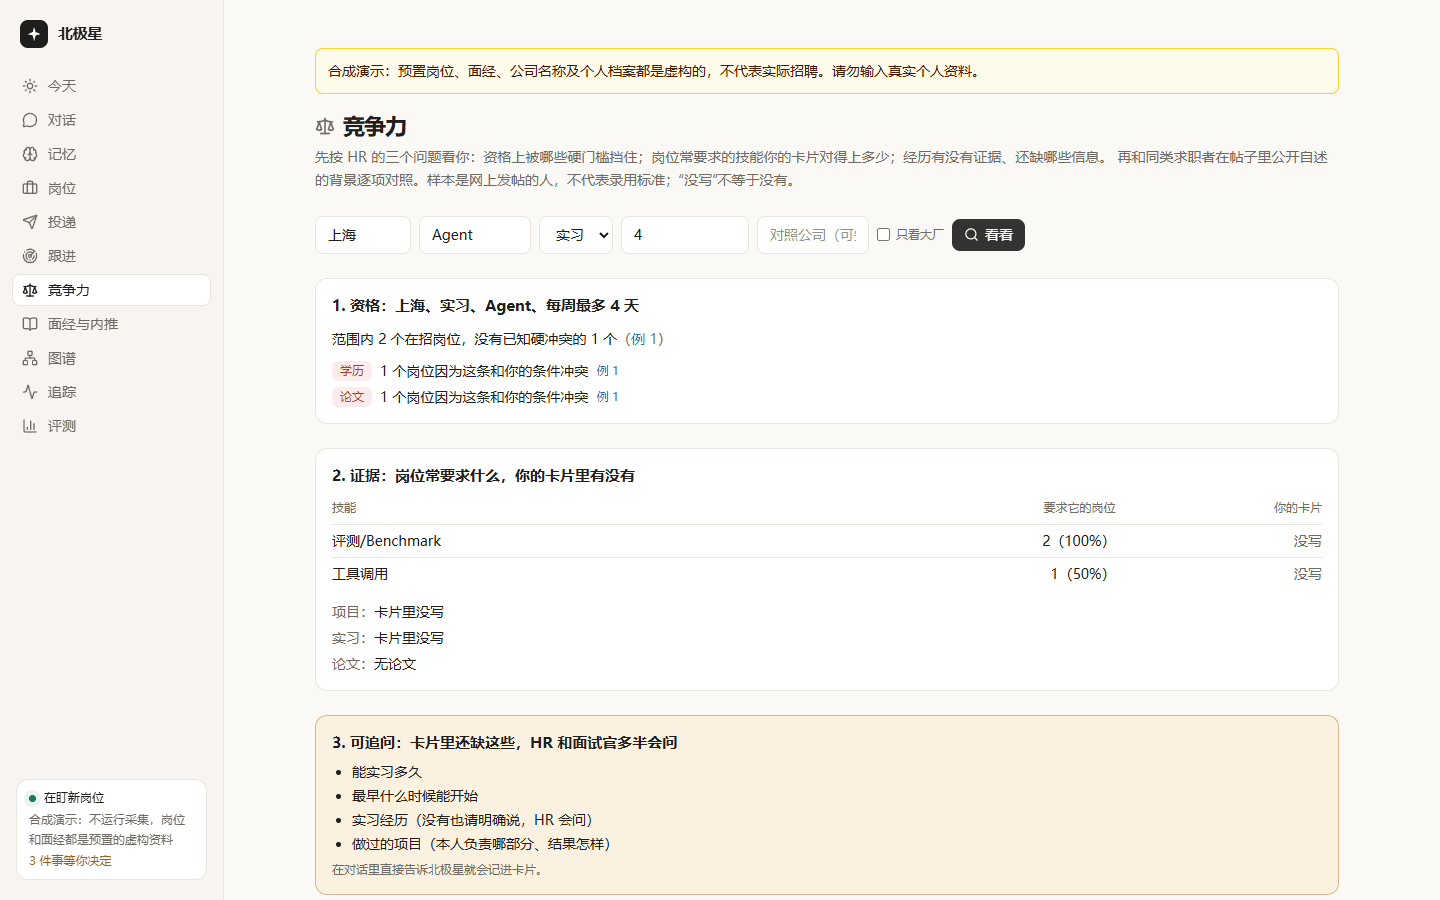
竞争力:硬门槛、技能对照、HR 会追问的缺口
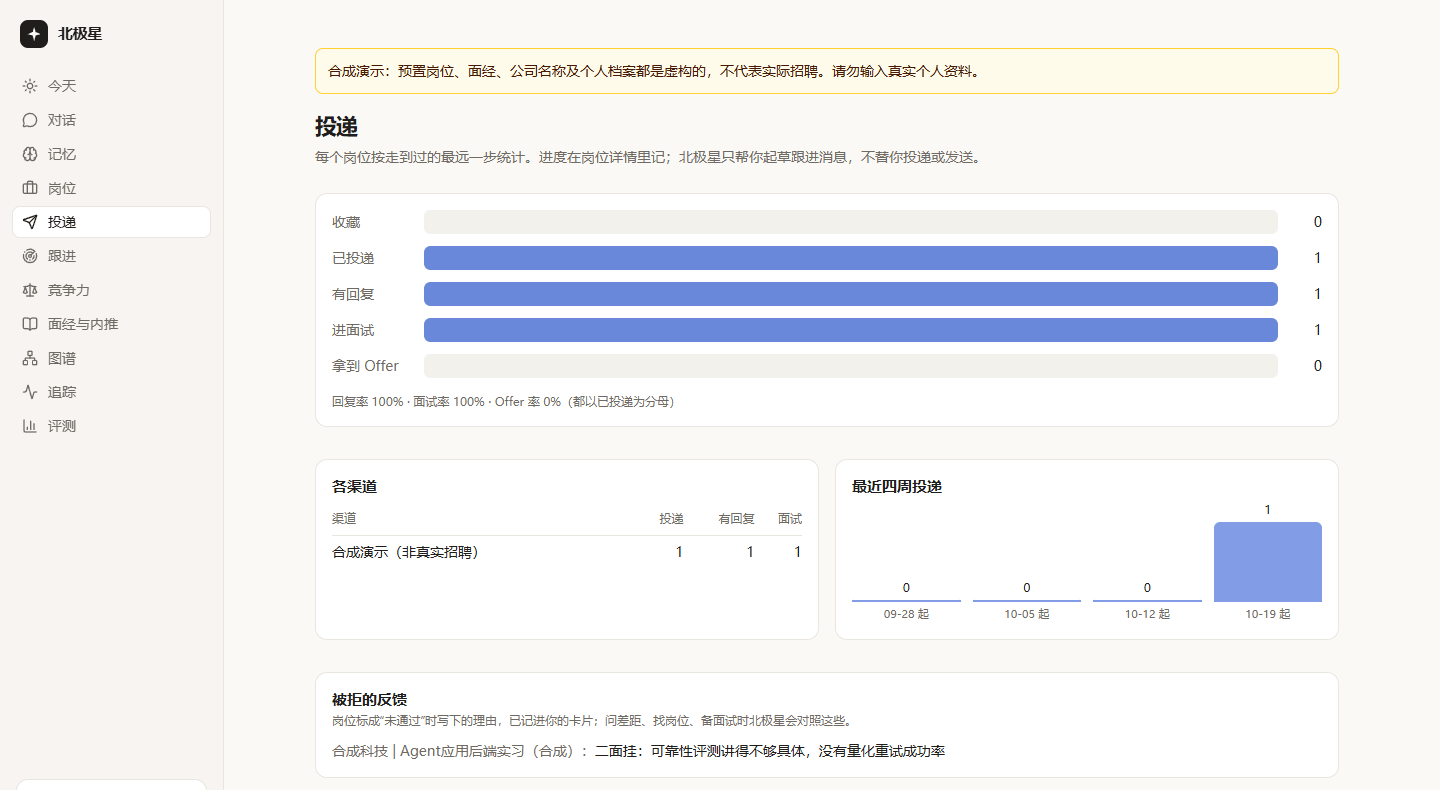
投递:按每个岗位走到的最远一步算漏斗;被拒理由记进卡片,之后问差距时会对照。
架构
采集只在本机、只读、低频;检索在 PostgreSQL 里做混合召回;对话由 LangGraph 编排,每次模型调用都记录 token、耗时和费用。
点图看大图。
一次请求在 Agent 里怎么走:
工程案例
都来自把系统真实跑起来时遇到的问题,离线测试一个都没发现。
| 现象 | 原因 | 改法 | 前后 |
|---|---|---|---|
| “北京 Agent 日常实习”只列出 1 个岗位 | 先在全库取前 50 个文本块再和条件范围取交集,范围内 40 个候选只剩 1 个;北京实习 207 个里 140 个没写每周天数,被整批排除 | 把范围内的岗位编号传进三路召回,先筛后排;没写天数的保留并标“待确认” | 召回 1 → 32 |
| 一次任务 265 秒,模型在一页页翻结果 | 工具结果上限 6000 字,每个岗位约 2200 字,一页只放 1~2 个 | 列表去掉重复的长解释,上限放到 16000 字 | 完整任务 77 秒 |
| 模型请求 30 秒后“连接错误” | 本机加速器的 TUN 接管了百炼流量,握手 1~8 秒常卡住;网卡直连 6/6 成功,约 0.2 秒 | 只对百炼域名、只在 DNS 返回假地址时,查真实地址并从默认路由网卡直连,失败退回隧道 | 103 秒 → 2 秒 |
| 回答说“在库里找到了一道面试题”,库里没有 | 模型没调面经检索就收尾;提示词里的禁令它照样跳过 | 编排层加证据门禁:要原题又没查过面经库时,退回去先查 | 原题都有出处 |
| 数据库没起,测试照样“通过” | 连不上测试库时整批跳过数据库测试,退出码仍是 0;一次 792 项里 306 项没跑 | CI 里连不上库就失败,用和演示同一个 ParadeDB 镜像 | PR #2 |
评测
10-11 到 10-13 的模块评测,数字只对当时的版本和题集成立。
技术栈
Agent
LangGraph 1.2 / LangChain 1.4:中间件做审批、调用上限、重试、证据门禁;Postgres checkpointer。
检索
PostgreSQL 17 + pgvector + ParadeDB pg_search(BM25,中文分词);Neo4j 图谱可选;加权 RRF、重排、MMR。
后端与网页
FastAPI、SQLAlchemy 2.1、Alembic、MCP;Next.js 16、React 19,可装到手机。
模型
阿里云百炼:对话 qwen3.7-plus,抽取 qwen-plus,向量 text-embedding-v4,重排 qwen3-rerank;换别家只改配置。
数据边界
- 官网公开岗位正常采集;小红书、脉脉、Boss 只在作者本机、用本人账号、只读、低频,遇到验证就停下。
- 采集的原文不进仓库、公开演示和提交材料;不采个人主页,不自动发消息、不自动投递。
- 公开演示只用手写的合成资料,独立数据库、API 和网页,每天有调用上限。